服务器•存储频道
随着AI训练与推理集群将单机柜功率从过去的10~30kW迅速推向100kW甚至更高,数据中心供配电架构正面临一场变革。传统交流供电在电流增大、铜缆数量增加、配电空间占用和能效优化等方面日益吃力,800V直流由此被推向舞台中央。然而,在施耐德电气中国中心电源解决方案研发总监徐康看来...
华为坤灵要做的正是把每一个场景做透,把每一个痛点解决到位,让智能真正落到每一家企业的日常经营中去。华为坤灵正在用行动回答我此前的疑问:深耕,不是慢,而是快;不是窄,而是深。当分销市场的智能化转型进入“最后一公里”,真正稀缺的不是更多...
近日,在华为全联接大会2026期间,华为公司董事、华为云CEO周跃峰发表了“共建Agentic Cloud,共赢行业智能体时代”主题演讲。题眼落在共建和行业两个词上,这恰恰点出了华为云对当前AI产业阶段的核心判断:智能体正在从技术概念走向行业落地,而落地的前提,是需要一个足够开放、足够扎实、足够懂行业的云底座。
过去两年,全球AI产业的关键词是“抢GPU”。从Meta、微软到xAI,动辄十万卡级别的集群建设不断刷新着人们对算力规模的想象。在这一背景下,笔者有幸采访到了Akamai云计算首席技术官Jay Jenkins,围绕AI算力的分配逻辑、推理场景的隐性成本、分布式架构的合规价值以及多智能体时代的基础设施挑战,进行了深入探讨。
华为坤灵要做的正是把每一个场景做透,把每一个痛点解决到位,让智能真正落到每一家企业的日常经营中去。华为坤灵正在用行动回答我此前的疑问:深耕,不是慢,而是快;不是窄,而是深。当分销市场的智能化转型进入“最后一公里”,真正稀缺的不是更多的方案名称,而是能解决实际问题的场景化能力。
随着AI训练与推理集群将单机柜功率从过去的10~30kW迅速推向100kW甚至更高,数据中心供配电架构正面临一场变革。传统交流供电在电流增大、铜缆数量增加、配电空间占用和能效优化等方面日益吃力,800V直流由此被推向舞台中央。
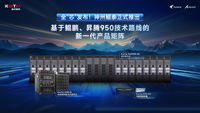
近日,2026华为全联接大会在上海召开。借此大会契机,神州鲲泰正式推出基于鲲鹏、昇腾950技术路线的新一代产品矩阵。首批发布的新品包括基于鲲鹏950的KunTai R722 K3均衡型服务器,以及基于昇腾950DT的KunTai A989 I5标准服务器、KunTai A989 I5风冷超节点、KunTai PoD2000 A5液冷超节点。
今日,华为全联接大会2026在上海启幕,华为副董事长、轮值董事长汪涛发表题为“智启新未来,打造智能世界的硅基黑土地”的主题演讲,发布全球首个采用NPO技术的超节点——昇腾960超节点,加速十万亿规模的大模型训练和推理。
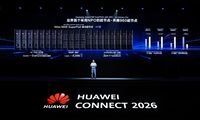
今日,华为全联接大会2026在上海启幕。华为副董事长、轮值董事长汪涛在大会上发表了“智启新未来,打造智能世界的硅基黑土地”的主题演讲,与产业界共同探讨在智能浪潮中如何携手合作,打造强大的AI基础设施,筑牢坚实的算力底座,迎接智能世界带来的机遇与挑战。
今日,华为坤灵新品发布会2026在上海举行。华为常务董事、ICT BG CEO杨超斌宣布,华为坤灵全面升级 “4+10+N” 一站式场景化方案,发布20款新品,并面向中国分销伙伴发布“经纬计划”和50个样板点,让智能世界触手可及。
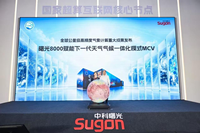
全球数值预报向1至5公里迈进,异构计算正成为重要支撑。近日,MCV数值模式依托曙光8000实现全球公里级预报计算时效达标,为这一技术路线增添了国产应用实践。
近日,以“赋能AI计算的未来”为主题的Arm Everywhere China年度大会盛大召开。在AI从生成式走向智能体的关键节点上,产业界对计算底座的关注度正在急剧升温。行业需要一个既能提供开发者所需一致性,又能赋能差异化创新的平台。Arm正在试图证明,它就是这样的平台。

日前,Arm 控股有限公司举办 Arm Everywhere China 年度大会,以“赋能 AI 计算的未来”为主题,吸引近 2000 名来自产业链上下游的行业领袖、开发者及生态伙伴报名参会,共同探讨智能体时代的计算创新与产业发展机遇。
2025年的夏天,如果说有什么比天气更热,那一定是“苏超”。从“苏超”赛场的内容破圈,到荔枝大模型的三年布局,再到与华为联合发布智能广告系统、发起“传媒智能助手”应用创新挑战赛,江苏广电总台正一步步揭开数智蝶变的幕后逻辑。江苏广电总台的AI布局,并非始于“苏超”的出圈瞬间。
在齐鲁大地北端,黄河之畔的滨州,一场关于制造业未来的静默变革正在发生。然而,动辄千万、上亿参数的大模型,如何真正走下云端,适应高温、高噪、高精度的工业产线?被誉为新石油的算力,如何才能精准地注入实体经济最渴求的脉络?带着这些问题,笔者实地探访了已跻身国内第一梯队的魏桥国科智算中心。
在 Agent 落地的过程中,我们很快会遇到一个现实问题:效果还没跑出来,账单先跑出来了。本文基于我们在agent项目中的真实实践,从基础认知到架构优化,系统梳理 6 个 Token 节省手段。简单方法立省 50%,高级方法降幅可达 90%+。
近日,中科曙光发布新一代词元加速方案ParaCache。它不是算力芯片,不是大模型本体,而是一个聚焦于KV Cache全层级管理的词元引擎。这组数据背后,暗含着一个清晰的信号:全球大模型的算力消耗重心正从训练全面转向推理,AI基础设施的建设思路,正在经历一场从堆砌GPU到存算协同的结构性转身。