国产算力为火箭回收“拍了一部三维电影”
火箭回收,是商业航天最难啃的骨头之一。SpaceX的星舰一次次迭代,让可重复使用从概念走向工程现实,也让国内航天界感受到紧迫。但很少有人注意到,回收成败的关键,藏在箭体底部那几十股高温高速尾焰的相互干扰里。
近日,中科曙光联合西安交通大学科研团队,依托全国产十万卡AI超集群曙光8000,完成超大规模多喷口超声速射流高精度数值模拟,创下国际已知最大规模的同类仿真纪录。双方向我们生动讲述了如何用国产算力攻克可重复使用火箭研发中最棘手的难题。
一个被工程需求逼出来的课题
“这个项目不是从论文里长出来的,是被工程需求逼出来的。”西安交通大学航天航空学院教授、博导,陕西省先进飞行器服役环境与控制重点实验室副主任姬兴开门见山。
在可重复使用运载火箭预研中,一个缺口浮出水面:重型火箭起飞和回收反推阶段,多机并联尾焰相互干扰的精细化仿真数据,国内极度缺乏。
为什么缺?一是能负担大规模计算的相关算法和工业软件缺失,二是对应的算力平台也没有。要补的不是一个点,而是一条链,算法软件要自己做,算力平台要自己找。
前期,西交大与中科曙光在光合生态项目上有合作基础。2025年,团队赴天津参与中科曙光异构计算平台的小规模性能测试,一拍即合。重大工程的需求、国产算力的能力、多年的算法积累,三件事在同一个时间点撞上了。
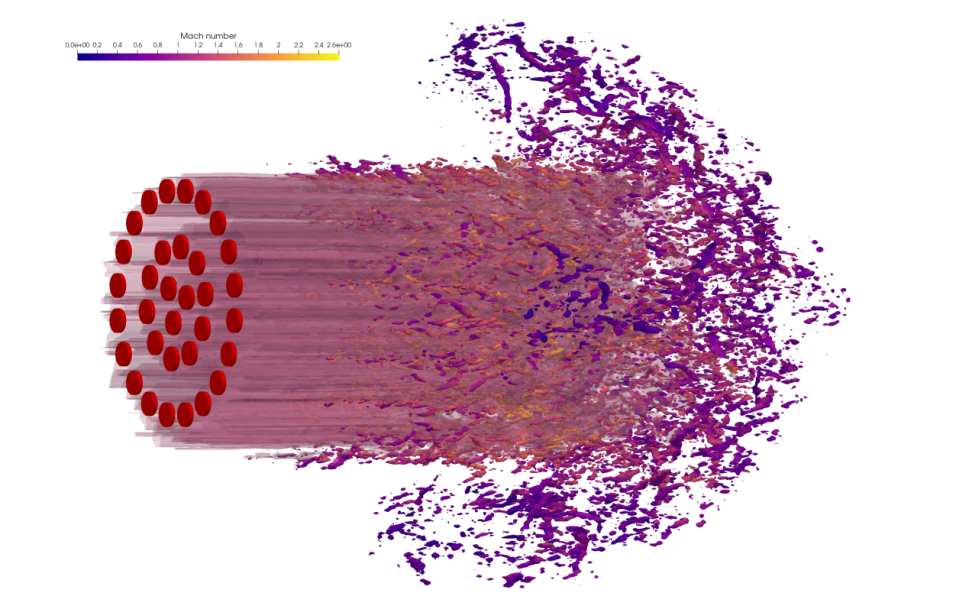
33个喷口,为什么传统试验测不全、抓不住、做不起
姬兴用一个比喻解释难点:拿一个花洒,33个喷口同时喷水,花洒本身会受到剧烈且不断变化的力。火箭底部喷嘴在极端情况下强度很容易被破坏,振动还会向上传递,箭体为了多装燃料壳做得很薄,很容易被晃散架。
更棘手的是热。射流温度约3000K,即2700多摄氏度。本来朝下喷的火焰,相互干扰后可能返回喷嘴附近,这叫回流,会把它烧坏。但烧坏的范围随时间剧烈波动,你不知道在哪儿、什么时候被烧坏。
西安交通大学博士生张红将传统试验的局限归纳为九个字:测不全、抓不住、做不起。试验只能在箭体表面布置有限传感器,就像用几支温度计去量一整片火场,最烫的角落恰恰可能是没放温度计的地方。
脉动压力是结构疲劳的主要来源,但测点一多,传感器本身又会扰动流场。地面缩比试验更难同时复现真实尺寸、喷口间距、环境压力和马赫数,多台发动机并联点火,一次试验代价极高,根本不可能换个喷口排布再试一次。
仿真的价值正在于此。试验能告诉我们这里有多热,但很难告诉我们为什么这里最热、换个排布会不会更糟。数值模拟能把整个空间点亮,任意位置、任意时刻、任意切片都能回放。
换一套底层算法,而不是打补丁
但要把这件事算出来,远不是堆GPU那么简单。张红坦承,团队此前在英伟达卡上做过基础程序,因为它最成熟,可以先跑通。但到了国产平台,矛盾变了。
最大的难点不是把代码移植过去,而是国产芯片算力长得比带宽快这个脾气,跟高阶CFD算法爱跑腿的老习惯不合。
张红用厨房比喻:一张加速卡像厨房,厨师(计算单元)越来越快,但从冷库(显存)往案板搬食材的通道(带宽)没变宽。传统多层Runge-Kutta方法,厨师每做一道菜要跑好几趟冷库,N步的Runge-Kutta,理论最优效率顶天就是单步法的1/N。
团队没有打补丁,而是换了底层算法,气体动理学格式(GKS)。它由华人学者徐昆教授发展,徐教授也是重要合作者。GKS从更微观的玻尔兹曼方程出发,关键特性是时空耦合:时间演化和空间通量在同一步算出,能直接给出通量对时间的导数。
过去评价它计算量大、在CPU上跑不快,是个缺点。但今天摆在国产芯片面前,这个缺点正好变成优点:国产芯片最不缺浮点算力,最缺的恰恰是带宽。
姬兴补充了关键数据:同功耗下,曙光8000的高精度计算能力是A100的3倍,它不缺高精度计算能力,比较劣势是带宽。单层方法正好匹配了这个优势。
近10万张卡、6.774万亿网格
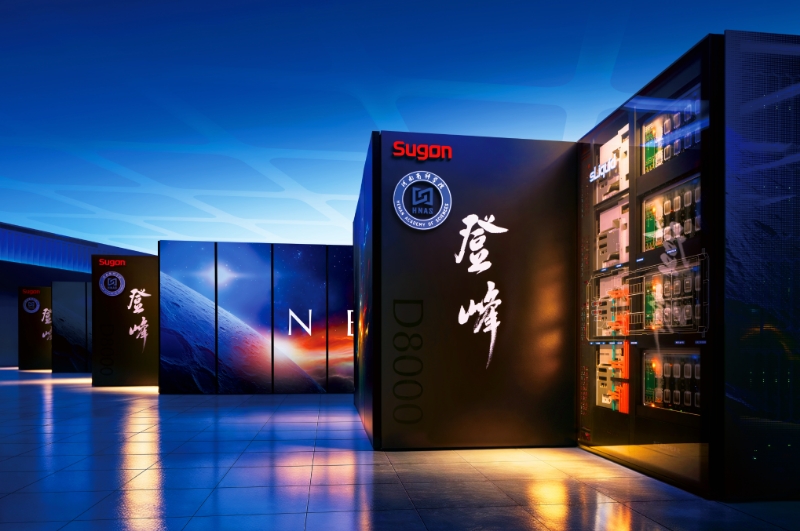
最终成果是:近10万张国产智能芯片、6.774万亿网格,弱扩展效率99.01%、强扩展效率73.00%、吞吐率34.029TCUPS、双精度有效算力0.249EFLOPS。
“这意味着计算资源与任务规模同步增加时,仍能保持接近理想的扩展效率。”张红说。代码层面做了三件事:换推进方式,通信轮次成倍下降;算子融合、少存多算,中间通量数组不落显存;把通信藏起来,内部区先算、边界数据后台收发,两者重叠。整个程序用MPI+HIP编写,不依赖GPU-aware MPI,在国产软件栈上直接就能部署。
姬兴对曙光8000的印象偏工程震撼:浸没式全液冷散热技术,能把这么多卡布局在如此紧凑的空间下保证并行运行,非常令人惊叹。软件栈自主化程度也很高,我们已经能在上面直接部署相当复杂的CFD代码,不再依赖国外的CUDA生态。
从“研算”到“智用”
姬兴将项目分为四个阶段:研、算、智、用。研是研制基础算法根技术,算是在国产机器上真跑起来、跑得稳、扩得动,智是用智能算法建立高效模型,把算一次要很大代价变成秒级给出工程可用的估计,用是真正用到型号预研里去。曙光8000这次的成果,标志着研和算的标志性收尾;接下来的重头戏是智和用。
预期成果有三:形成多喷口尾焰干扰的全场三维瞬态高精度数据集;建立高效智能模型,把数据集变成工程上随手可用的设计工具;形成自主可控的仿真底座,为重型、超重型火箭预研提供基础科学支撑,并进一步拓展到商业航天企业。
最缺的是“啃硬骨头的人”
当被问及科研界、航天工程单位还需补齐什么能力时,姬兴表示,工程单位缺算力,正在补;数据安全对接通道也要打通,这一条打通了,效率提升可能比优化算法还明显。
科研界缺的则是啃硬骨头的耐心和保障,这条最难,也最重要。大家擅长理想工况、简单模型下的算法,但真正能打的是复杂物理场、复杂几何下的实战能力。这类能力不容易发文章,周期长,短期看不到回报,需要长期稳定的支持。
高等学校积聚了最有时间和创造力的博士生和青年教师,如何让他们安安心心去啃硬骨头,给他们充分的物质保障和稳定的预期,是需要认真思考的。硬件可以买,软件可以写,但能啃硬骨头的人,是要花时间养的。国产算力生态真正建成的标志,不是有多少台机器,而是有多少年轻人愿意、并且能够在这条路上长期做下去。
一场全链路自主的大胆尝试
中科曙光研发工程师梁超总结中科曙光的角色:不仅是提供算力,更希望发挥算力底座+软件环境+规模验证+专业技术服务的综合能力。从编译、运行时、数学库、通信库到作业调度,中科曙光与应用团队联合攻关,通过逐级扩展验证、全链路监控和问题定位,保障数万卡规模下的稳定运行。
姬兴表示,我们不是把国外代码翻译到国产卡上,而是为国产卡的脾气,精挑细选的一套基础算法,这才是这件事真正的创新所在。
从工程需求出发,缺算法、缺软件、缺算力,三样一起缺,所以自己下场把根技术做出来。这条路走通了,火箭回收的仿真只是开始。
正如姬兴所说,未来还有空天飞机,整个形态上会有更多变化,都会有喷流、气流的问题。而支撑这些探索的,不仅是数万张芯片的算力,更是一套从算法到硬件、从软件到生态的完整能力。这套能力,正在国产高性能计算的土壤里,一点点长出来。