
Token时代,存储为何必须“重造”自己?
AI的叙事正在换挡。过去两年,行业的目光几乎都聚焦在模型参数、训练算力和推理芯片上,存储往往被视作后台的仓库。
但当AI从生成内容迈入执行任务,当Agent开始承担长链路、多轮次、跨会话的复杂工作,一个被低估的瓶颈浮出水面:数据供给如果跟不上,再强的算力也只能空转。这正是2026数据存储产业大会释放出的关键信号。
作为专委会主任委员单位,中科曙光在会上展示了以“AI数据工厂”为核心的存储新范式,中科曙光分布式存储产品部总经理石静表示,存储在Agent时代,应当从被动的“数据容器”跃迁为主动的“AI数据工厂”。
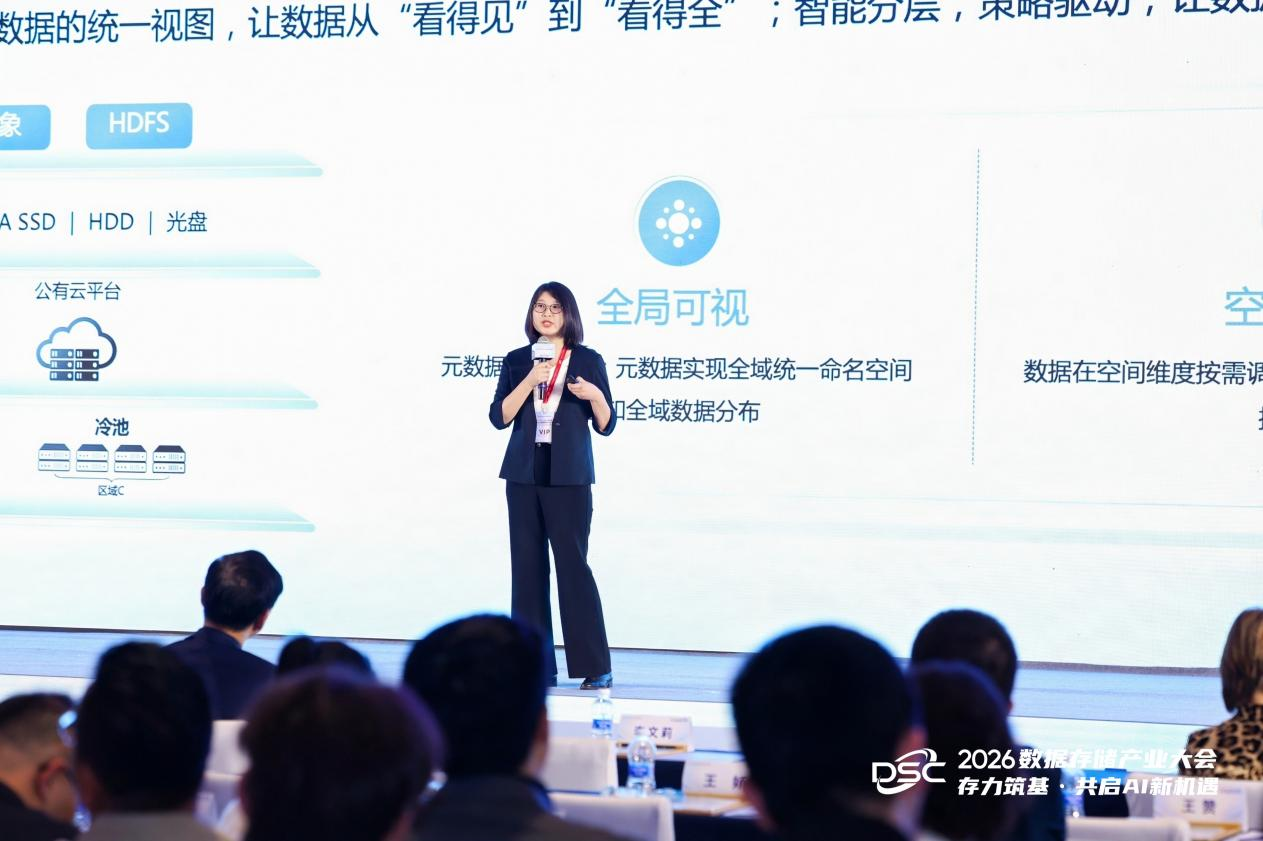
中科曙光分布式存储产品部总经理 石静
为什么“数据容器”不够用了?
理解这一判断,要先看清AI负载的变化。传统存储的考核指标是带宽、IOPS和稳定性,用户关心的是存得下、取得快。但在智能体场景下,数据不再只是训练时的一次性输入。长上下文需要持续驻留,多轮交互产生大量中间状态,跨会话任务要求计算结果可复用。
石静反复提到一个词——KV Cache。它是推理过程中Prefetch与decode之间的中间状态,命中率越高,重复计算越少,Token就越便宜。换句话说,存储不再只是存放数据的地方,而是直接参与Token生成效率的生产要素。
更本质的变化在于数据全生命周期管理。石静以卫星遥感为例:过去数据从在线到近线再到归档,路径固定、周期可预期,生命周期管理是可选项。而AI时代,全闪与混闪的分层架构成为必选项,数据要在不同介质、不同地域、甚至不同算力中心之间流动。生命周期管理从可选项变成必选项,范围也从单系统扩展到跨域。
这一判断点出了存储跃迁的现实基础:不是厂商讲故事,而是用户的使用方式已经变了。
“AI数据工厂”的四个层面与一条主线
石静将“AI数据工厂”拆为四个层面:全域数据底座、统一承载与智能调度、高效IO管道、融入AI业务流。这四个层面看似并列,实则有一条清晰的主线,让数据流动起来,让计算等数据的时间趋近于零。
第一个层面解决“看得见”。ParaStor与FlashNexus通过统一命名空间和多协议融合,让文件、对象、块、大数据接口互通,文件写入可由对象读出,反之亦然。更值得注意的细节是,曙光已支持原生KV Cache语义,这对推理场景的友好度是实质性的。
第二个层面解决“调得动”,依据数据热度与业务需求跨介质、跨平台调度,减少重复搬运。
第三个层面解决“传得快”,XDS数据直通、BurstBuffer本地缓存与scaleFabric网络协同,压缩IO路径。
第四个层面解决“融得进”,与向量数据库、RAG流水线配合,数据更新自动联动存储。
这套逻辑的核心,是用“存-算-传-用”全栈协同去挤压算力等待的空泡。石静举了一个很具体的例子:传统做法是把处理好的训练集从混闪拷贝到全闪,GPU在此期间只能干等。曙光的做法是按需加载原数据、边处理边推送,让计算与IO重叠。这个思路直击要害,AI集群里最贵的不是存储,是GPU闲置的时间。
KV Cache:存储价值重估的“试金石”
如今,大多数客户采购存储的预算逻辑仍是容量和带宽,而KV Cache是中间状态、不会长期存储,这之间存在认知落差。曙光给出的不是概念,而是一套可算账的评估路径。
第一条路径:当模型参数多、长上下文多,HBM不够、DRAM能包住时,比较外置存储与内存的性价比。石静给出一个测算比例,单TB分布式存储成本约为内存的1/40;若外置存储能达到内存效能的90%,满足TTFT要求,用户以极低成本换取略慢但可用的推理体验,账算得过来。
第二条路径:上下文极长、内存被打爆时,KV Cache必须卸载到L4分布式存储。此时比的是Token吞吐,曙光实测,相较GPU重新计算,卸载到L4后Token吞吐提升15到25倍。
这两个场景的对比很有说服力,因为它没有回避存储比内存慢的事实,而是把问题转化为在满足业务要求的前提下,哪种方案性价比更优。这是“AI数据工厂”落地的关键,工厂讲的是流水线效率和规模化,不是单点参数的军备竞赛。
双轮驱动与分层架构:协同而非替代
曙光长期坚持ParaStor分布式与FlashNexus集中式双轮驱动。在AI数据工厂的框架下,两者不是替代关系,而是分层协同。
训练阶段以分布式为主,集中式凭借低时延承担容器化部署中的本地镜像等高速块存储需求;推理阶段,曙光将两者包装为ParaCache方案:HBM为L1、DRAM为L2、本地SSD为L3、FlashNexus作为L3.5主打原生KV语义与P99长尾时延、ParaStor作为L4提供容量扩展与全局共享KV池。
业界不少厂商把分布式存储定位为KV Cache的“冷备层”,曙光却坚持L4生产级可用。这背后是对自身性能的自信,也是对“AI数据工厂”理念的贯彻,工厂的每一道工序都应在生产线上,而不是把半成品堆到仓库里。
笔者观察:存储的“主动化”是一场系统工程
笔者看来,曙光“AI数据工厂”的判断有用户实践支撑:用户开始要求算子下沉到存储、框架调度与存储结合、存储提前感知加载数据;介质成本上涨倒逼存储提效;绿色液冷从盘的液冷向CPU、DRAM延伸,软件层面通过功耗管控、大比例纠删码、重删压缩降低能耗。这些细节说明,“主动化”不是口号,而是被用户需求和成本压力推着走的现实选择。
但也要看到,存储从被动走向主动,挑战同样明显。长链路Agent任务对长时间稳定可靠性、KV Cache跨层级跃迁管理、P95/P99长尾时延平滑提出更高要求;海量小IO需要小文件聚合、BurstBuffer、元数据集群化与超级隧道技术共同支撑。
这些技术曙光都有布局,但“数据工厂”的真正考验在于:当业务流、调度框架、向量数据库、RAG流水线都要与存储深度耦合时,存储厂商能否从“卖盒子”转向“卖流水线”,能否与上层生态形成标准化协作,而非封闭优化。
Token时代存储的角色重估才刚刚开始,曙光给出了一个成体系的判断和可算账的路径,从国家超算互联网核心节点、智元机器人数采工厂、自动驾驶百PB级资源池等落地看,这条路已经有人在走,而且走得不算慢。

