
从训练到推理:中科曙光FN Neo定义AI存力新范式
进入2026年,人工智能产业的主旋律已经发生了位移。如果说前几年我们还在惊叹于大模型训练出的智力上限,那么现在,整个产业已经全面转向了推理落地的商业下限。
在智能体时代,AI不再是你问我答的单轮游戏,而是能够互相调用、进行数十轮推理循环的数字员工。IDC预测,Agent API调用量将在5年内增长1000倍。这意味着,Token正在成为新的生产材料,而推理生成Token的每一个环节都在疯狂吞噬着存力。
然而,一个长期存在的行业错觉是:“集中式存储不适合AI推理。”很多人认为,AI推理依赖本地NVMe盘的高性能,传统集中式存储由于协议栈厚重、延迟高,难以胜任。但事实真的如此吗?
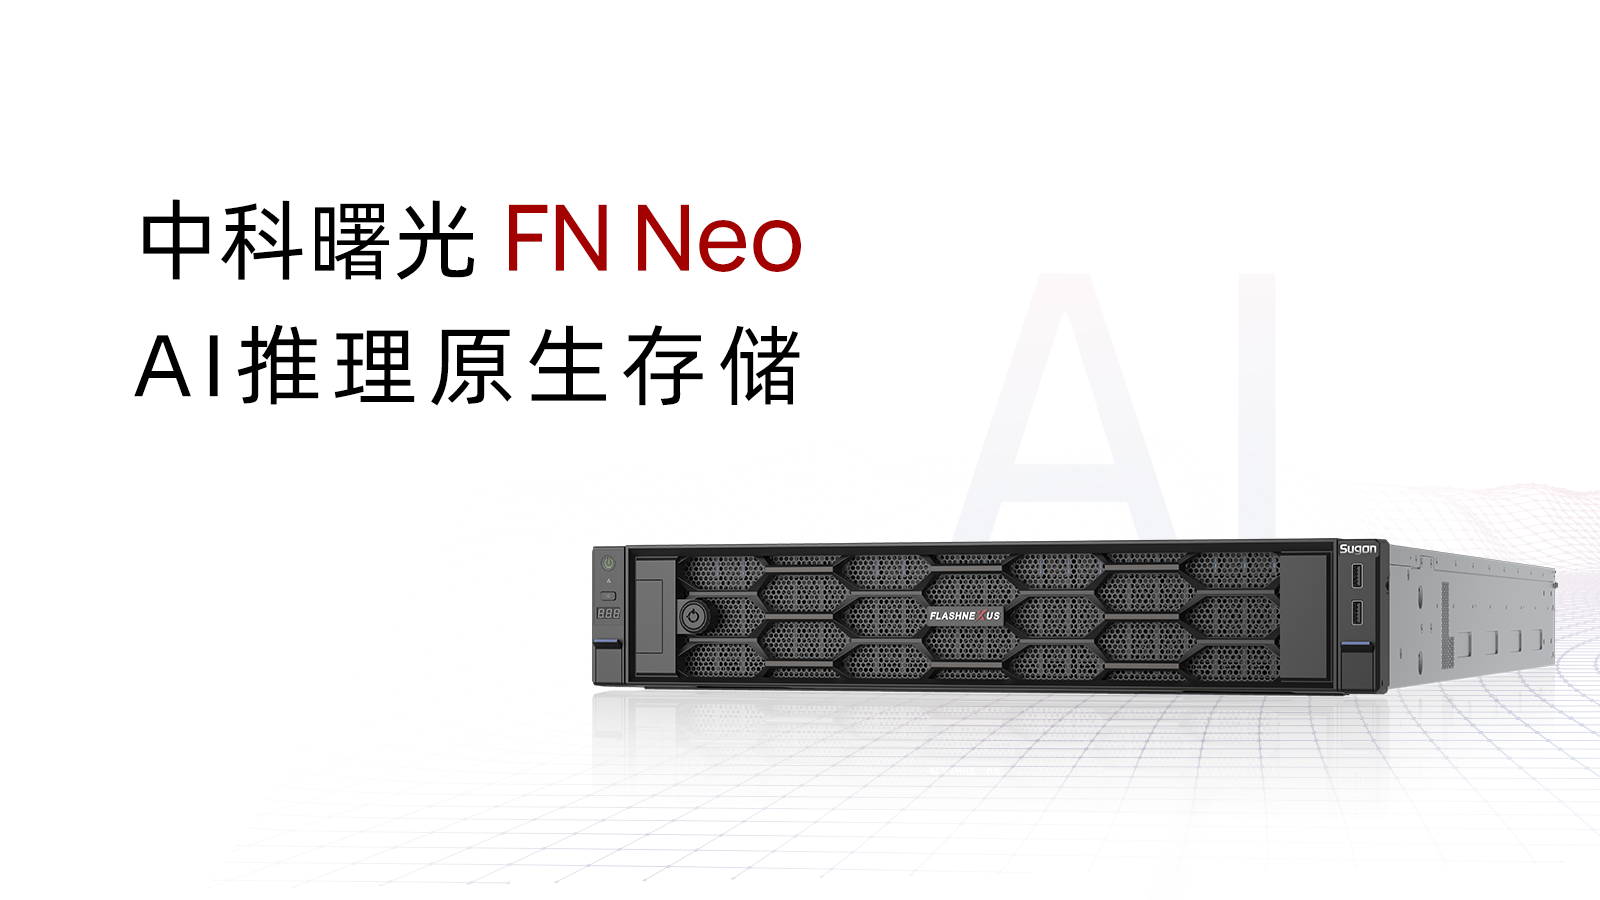
针对上述疑问,在2026年CCF全国信息存储技术学术会议上,中科曙光正式发布了全新迭代的AI推理原生存储FN Neo,用一套快、稳、开放的池化共享架构,对这一行业认知发起了强有力的挑战。
核心痛点:KV Cache从临时缓存到核心资产的跃迁
要理解FN Neo的价值,必须先理解AI推理正在发生的变化。在传统推理中,KV Cache往往被视为一种临时缓存,主要用于避免Transformer架构中的重复计算。但在长上下文、多轮对话、分布式推理以及智能体场景下,KV Cache的性质已经发生了根本性改变。
中科曙光集中式存储产品部总经理郭照斌表示,智能体带来的最显著变化是持续连续的上下文。在AI Coding等典型工程场景中,上下文甚至能达到上百兆的量级。如果KV Cache不能有效卸载,即使算力再强,GPU也会陷入大量的重复计算中,导致Token输出效率极低。此时的KV Cache,已经具备了数据资产的特征:它有生成成本、有复用价值、有生命周期,且需要跨节点共享。
然而,传统的节点本地缓存模式存在致命的资源割裂。KV Cache被绑定在单个计算节点的私有资源中,不同会话、不同节点之间无法互通。这导致大量宝贵的缓存数据被闲置,GPU显存极易溢出,算力资源被严重浪费。因此,行业亟需一种能够将KV Cache从节点私有缓存转变为推理集群共享资源的存力底座。
破局之道:FN Neo的池化共享与原生KV语义
中科曙光FN Neo的核心突破,在于其池化共享能力。它升级了传统集中式存储的池化逻辑,从单节点内的跨NVMe池化,升级为AI集群内的跨节点池化。在分层存储架构中,FN Neo处于L3层,首次将集中式全闪存储纳入KV Cache分层体系,实现了存储容量从服务器资源到集群资源的跨越。
但仅仅有池化是不够的。正如郭照斌所解释的,传统的集中式存储之所以在AI推理中水土不服,是因为其协议栈过于厚重。如果通过文件系统来实现KV Cache的回读回写,需要经历KV块-文件-posix接口-内核VFS-文件系统-存储设备等多个层级,涉及多次上下文切换、内存拷贝和元数据操作,开销巨大。
FN Neo的杀手锏在于原生KV语义。它摒弃了复杂的文件系统路径,直接提供KV原生通路。配合其自研的超级隧道技术,基于微控架构实现的零中断、零竞争、零拷贝数据通路,FN Neo将完整数据通路的延时目标压到了微秒级别,基础操作延时甚至做到了纳秒级。
这种原生KV语义的实现,不仅极大简化了数据通路,还通过基于Cache Line的检索加速技术,实现了300ns内定位到NVMe存储位置。这意味着,FN Neo不仅存得下,更能存得快。
实测数据:快2倍、省更多,性能与成本的双重碾压
郭照斌分享了一组令人印象深刻的实测数据。在单节点8卡DCU的测试环境中,使用DeepSeek-R1-Distill-Llama-70B模型,对比纯GPU显存、本地NVMe和FN Neo三种模式。
结果显示,FN Neo的逐轮TTFTP50显著快于本地NVMe,且优势随轮次扩大。在Round8时,FN Neo的TTFT仅为29秒,而本地NVMe为54秒,GPU纯显存模式则高达293秒。在吞吐量方面,FN Neo持续领先,峰值约202tok/s,相比GPU磁盘缓存提升约7.4%。
在多节点测试中,采用Qwen2.5-32B-Instruct模型,FN Neo在高并发下依然平稳。当并发数达到60时,FN Neo的TTFT仅为8.8秒,而GPU纯显存模式高达55.6秒,本地NVMe为34.1秒。FN Neo相对GPU加速6.3倍,相对Local加速3.9倍。在不同上下文长度下,FN Neo也稳定领先,上下文越长,优势越大。
这些数据背后,是FN Neo快、稳、开放三大核心能力的支撑。
快:单阵列带宽可达160GB/s,NAS带宽可达70GB/s,亚毫秒级延时。配合方案实测TTFT缩减73%,Token吞吐能力提升150%。
稳:具备99.999%高可靠性。在AI长程推理中,用户对尾延迟极其敏感。FN Neo通过全局缓存镜像、RAID-OC、自动缩列修复以及慢盘自动隔离技术,保障了长程推理过程中TTFT、TPOT和端到端延迟的稳定性,满足金融级稳定要求。
开放:坚持三重开放策略。在推理框架层面,兼容vLLM、SGLang、LMCache、HiCache、Mooncake等主流框架;在组网部署层面,适配RoCE/IB/国产400GIB/FC/IPSAN多种组网;在操作系统层面,兼容多种主流OS。
郭照斌强调,FN Neo提供全用户态客户端组件,无内核模块嵌入,对计算节点影响极小,实现了无感接入。
商业价值:中小规模算力集群的一站式存力底座
在商业落地层面,FN Neo展现出了极强的实用性。郭照斌表示,FN Neo的核心目标场景是中小规模的算力集群,例如10到20台算力卡组成的独立集群,或者搭配曙光X40超节点的10个计算节点、40卡规模的集群。
郭照斌算了一笔账:一套基础版FN Neo,2U25盘位,双控制器,就能满足核心KV Cache卸载的诉求。同时,它还原生直出NAS协议和块协议,满足推理过程中模型权重共享、容器镜像存储、向量数据库加速、智能体临时文件卸载等全场景需求。
这意味着,用户只需要配置一台外置存储,就可以满足整个推理过程。FN Neo通过一套设备、一个存储池、三种原生协议,实现了一站式支撑智能体推理全场景。
此外,FN Neo的横向和纵向扩展能力也极具灵活性。纵向扩展可以直接扩展不带CPU的硬盘框,低成本提升容量;横向扩展可以增加控制框,实现性能和容量的同步扩展。全局统一命名空间让用户无需感知扩容过程,业务无感。
笔者观察:存力定义算力效率的时代已经到来
在AI推理规模化落地的关键节点,中科曙光FN Neo的发布证明了集中式存储完全有能力胜任高并发、低时延的AI推理复杂负载,并通过池化共享架构,将KV Cache从节点私有缓存升级为推理集群共享资源。
存储成本的降低对于用户的选择和私有化部署落地的困难度,其实就会减少很多。FN Neo通过快、稳、开放的高效融合,让企业无需大规模改造现有推理环境即可完成接入,显著提升了GPU等昂贵计算硬件的整体利用率。
在Token成为新生产材料的时代,存力不再仅仅是算力的配套,而是正在成为定义算力效率的核心基础设施。中科曙光FN Neo的推出,补齐了AI推理场景下集中式存储的能力拼图,为Agent、长上下文大模型等业务的大规模落地,提供了一套经过工程验证的存力新选择。

