
神州鲲泰“双芯”矩阵发布,国产算力底座进入系统级竞争时代
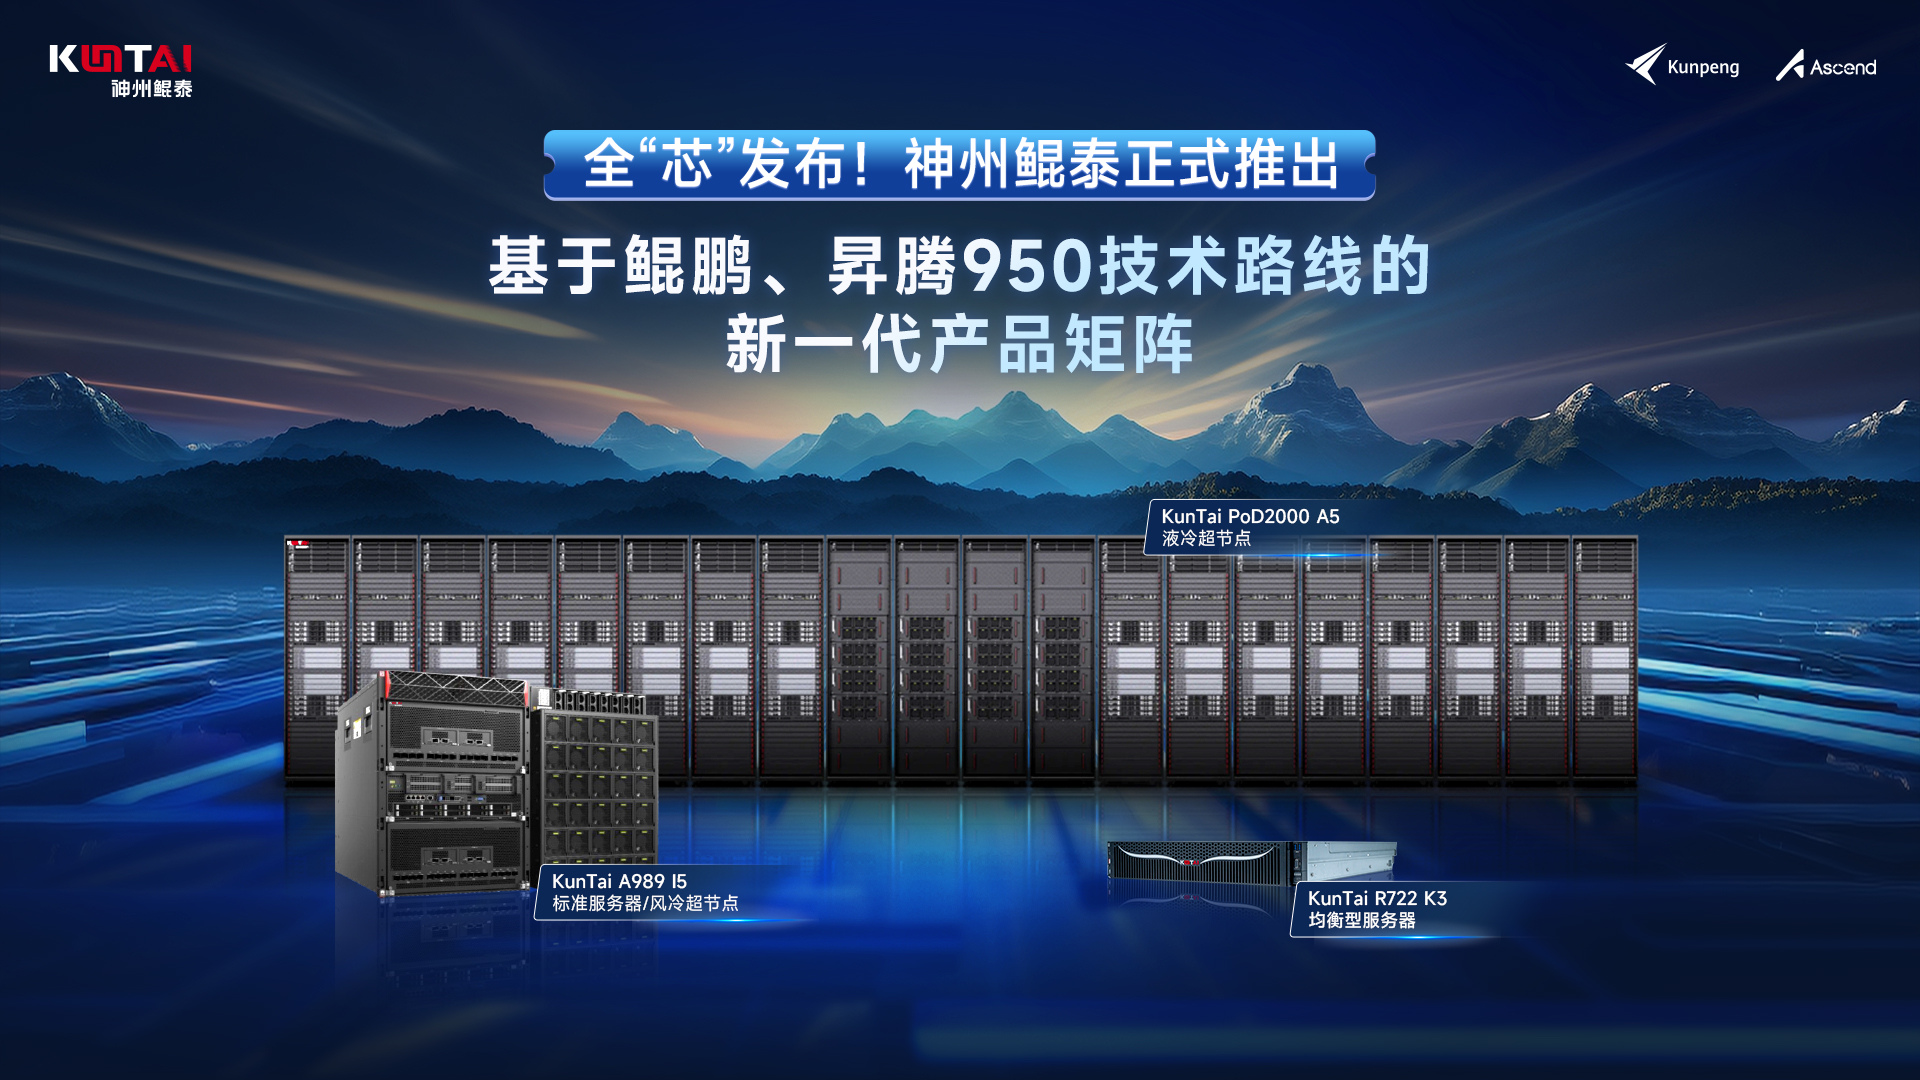
近日,2026华为全联接大会在上海召开。借此大会契机,神州鲲泰正式推出基于鲲鹏、昇腾950技术路线的新一代产品矩阵。
首批发布的新品包括基于鲲鹏950的KunTai R722 K3均衡型服务器,以及基于昇腾950DT的KunTai A989 I5标准服务器、KunTai A989 I5风冷超节点、KunTai PoD2000 A5液冷超节点。四款新品覆盖通用计算、大模型训练、高性能推理等场景,构成通用算力+AI智算双轮驱动的完整国产化算力底座。
产业拐点:为什么超节点成了热词
当前AI技术迭代呈现两个显著特征:大模型参数量百倍级扩张,MoE稀疏架构与Agentic智能体应用快速兴起。训练向万亿参数演进,推理进入超长上下文、海量Token、多模态协同的新阶段。传统依靠以太网RoCE组网的服务器堆叠集群,在通信时延、内存墙、算力MFU利用率上遭遇瓶颈,难以充分释放新一代芯片的全部能力。
神州鲲泰产品专家孙亚楠给出了一个清晰的产业判断:超节点已成为大规模训推任务的更优解,是AI计算与高端通用计算的关键技术方向。但问题在于,当超节点成为行业热词,市场上充斥着各种宣传口径,如何区分真正的超节点与普通服务器堆叠?
他给出了三条硬性标准:其一,专用高速硬件总线互联,如灵衢UnifiedBus,区别于以太网RoCE的消息通信,减少协议转换与数据拷贝带来的时延开销;其二,全域内存统一编址,支持内存语义Load/Store远端内存,无需数据拷贝,这是与普通集群最本质的差异;其三,端到端全栈软硬件协同,芯片、互联硬件、CCU、驱动、操作系统、通信库完整适配。
“仅用以太网组网,哪怕硬件规格再高,只是服务器堆叠,无法突破内存墙与通信瓶颈,算力无法充分释放。”孙亚楠的这句话,实际上为当前火热的超节点赛道划出了一条技术分水岭。神州鲲泰此次发布的全线产品,均按照这套标准设计,这既是产品自信,也是对行业话语权的一次主动争夺。
鲲鹏950:通用算力的跃迁
神州鲲泰此次发布的KunTai R722 K3均衡型服务器,是鲲鹏950处理器的首发整机载体之一,从产品参数看,其升级幅度在通用计算领域堪称激进。
微架构重构带来整机性能提升1.4倍,针对业务场景定制优化内核后业务性能提升35%;支持SVE2,优化INT8矩阵向量吞吐。IO层面,内存带宽提升2.25倍,核访比达到1:3.6;新增DPA加速,面向大数据、数据库场景提升应用性能;首发灵霜接口,提供大带宽、低时延能力,支撑鲲鹏超节点池化应用。
更值得关注的是封装技术:业界首款3D封装处理器,Dielet“零距离通信”,实现更高通道通信带宽、更低Die间通信延迟,可支撑更多核心、更大Cache。可靠性方面,支持CPU故障隔离及修复,新增L3上电替换,内存纠错技术实现内存Cache Line冗余修复。安全层面,支持内存加密与CCA机密计算架构,实现满带宽内存加密,加密不影响内存访问带宽。
孙亚楠在解释通算超节点的价值时,给出了一个具体场景:传统以太网分布式集群存在三大痛点,跨机访问时延高、内存资源碎片化、IO硬件资源孤岛。
KunTai R722 K3可以通过灵衢总线组网,多台物理节点形成一台逻辑大计算机,跨节点内存、SSD、DPU资源池化,百纳秒级内存语义访问,省去大量数据拷贝,这对金融、运营商、政务核心数据库、交易系统迁移,意义重大。
客户可以单机独立部署,也可以按需开启超节点组网,实现业务分步改造。这种渐进式迁移路径,降低了核心业务系统国产化替换的风险门槛。
昇腾950DT:从液冷极限到风冷普惠的推理矩阵
AI智算侧,神州鲲泰此次一口气推出三款昇腾950DT整机,形成清晰的分层布局。
KunTai PoD2000 A5液冷超节点面向万亿级大模型训推场景,主打极限算力密度。最大可实现1024卡集群部署,256TB内存统一编址,算力利用率MFU可达约45%,相比前代提升30%。全栈工程优化依托低温混流装甲冷板、高效TPSU电源、柜级正交架构、星云8000LPO光互联、2+2光路保护等创新,实现功耗、散热、互联、供电全方位优化。千卡MTBF高达300小时,这一可靠性指标在超大规模集群中颇具分量。
KunTai A989 I5风冷超节点则面向企业级数据中心,定位Agentic极致推理。单计算节点支持8颗NPU,最大提供14.2PFLOPs@mxFP4算力,内存读写带宽最高4.0TB/s;通过灵衢2.0协议,整框NPU互联总带宽可达13.4TB/s。产品适配通用风冷机房,无需改造液冷基础设施。推理吞吐可达前代A3节点的1.5至2.0倍,业界唯一实现5ms极致时延,FP8/FP4等多精度算力完整支持。
KunTai A989 I5标准服务器则主打灵活部署与按需扩容。单机支持8颗NPU模组,最大输出12.4PFLOPs@mxFP4算力,依托灵衢互联协议实现双机16卡Full-mesh全互联组网,NPU之间无转发直连,降低通信时延。模块化架构设计支持按需横向扩容,可从小规模集群平滑扩展。
孙亚楠在对比风冷与液冷方案时,坦率地指出了设计取舍:KunTai PoD 2000 A5液冷整机柜追求极限算力密度,适合新建大型智算中心、万亿大模型预训练,但对机房基础设施改造要求高;A989 I5风冷超节点完整保留超节点三大核心能力,在散热、功耗上做工程优化,无需改造液冷管路,直接利用传统风冷机房,支持单层组网96卡、双层组网768卡超节点规模灵活组网。
牺牲单机柜极限算力密度,换取存量机房兼容。这种务实的产品定义,实际上瞄准了一个更广阔的市场,大量已有风冷机房的中型智算、政企AI平台、运营商区域算力节点。
生态协同:整机伙伴的不可替代性
通用算力侧,基于鲲鹏950完成整机硬件、散热、驱动适配,支持灵衢组网通用超节点;AI智算侧,基于昇腾950DT原生超节点能力,自主完成PoD2000A5、A989I5整机结构、灵衢互联、供电散热、软硬件联合调优。
神州鲲泰把芯片原生超节点能力转化为标准化可交付整机;同时将整机测试、客户验证中发现的互联、散热、适配问题反馈华为,双方持续迭代整套软硬件体系。这种双向反馈机制,正是算力生态从“芯片定义整机”走向“场景定义系统”的缩影。
笔者观察
站在2026年的产业节点回望,国产算力的竞争逻辑已经发生根本性转变。单芯片算力的参数比拼正在让位于“算—网—存”系统协同能力的较量,服务器堆叠的规模扩张正在被超节点的逻辑统一所取代。
国产超节点产业尚处早期,但方向已经明确:从芯片到整机,从互联到软件栈,从单点突破到全栈协同,这场系统级竞争的胜负手,不在于谁的单卡跑分更高,而在于谁能把芯片的原生能力,转化为千行百业可交付、可运维、可扩展的算力底座。

